

robots.txtとは?AI検索時代に知っておきたいクロール制御の基本
robots.txtで何を制御できる?検索エンジンや各種クローラーへの基本的な設定方法を解説します
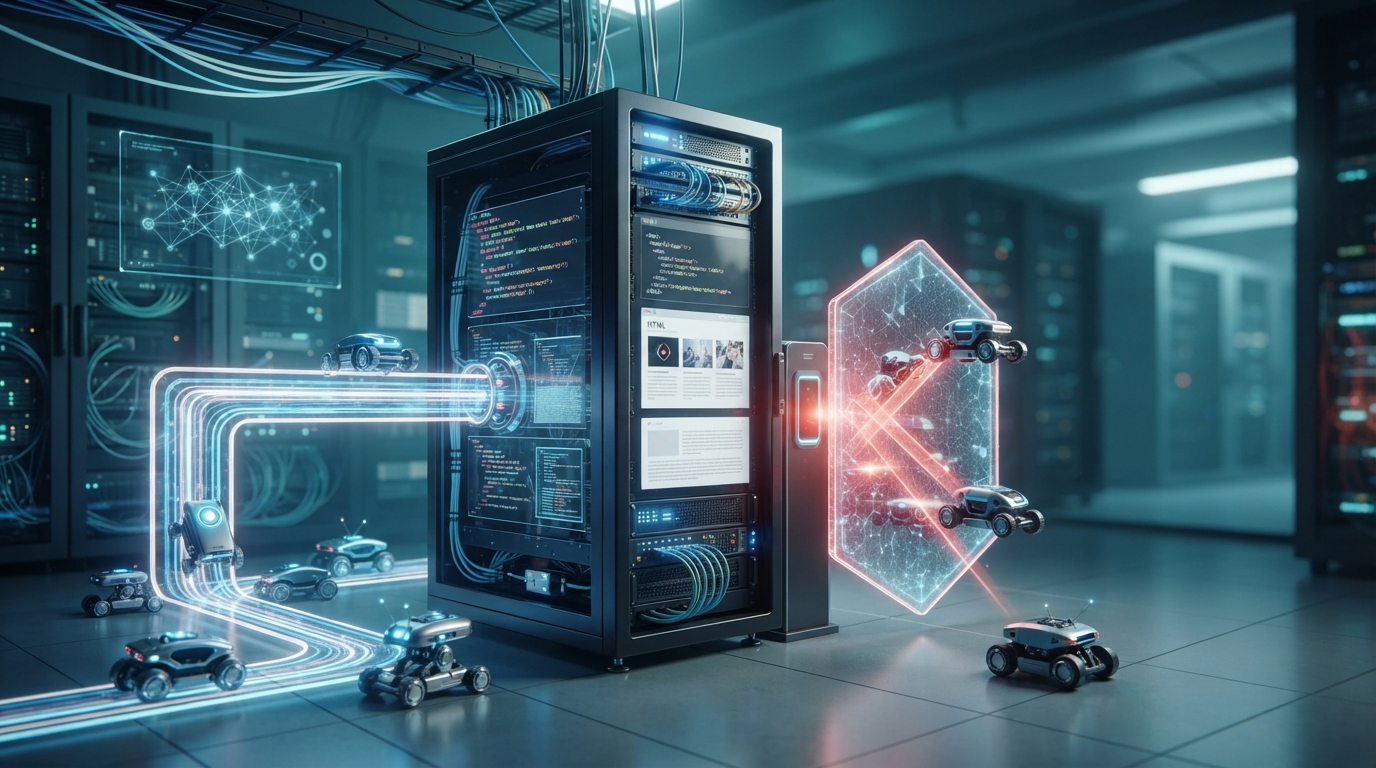
robots.txtは、検索エンジンやAI検索のクローラーに対して、企業サイト内のどのページを巡回してよいかを伝えるためのファイルです。正しく設定すれば、不要なページのクロールを抑えられ、重要なコンテンツの発見や評価を妨げにくくなります。
この記事のポイント
robots.txtは、サイトの入口に置くクローラー向けの案内ファイルです。非公開にしたい情報を守る仕組みではなく、クロールの優先順位を整えるSEO施策として活用します。AI検索の時代には、良質な企業情報や専門記事をクローラーが取得できる状態に保つことが重要です。
今日のおさらい:要点3つ
- robots.txtは、Googleなどの検索エンジンや各種クローラーの巡回範囲を指定するファイルです。
- robots.txtで記事ページまでブロックすると、SEOだけでなくAI検索で参照される機会も失うおそれがあります。
- 企業サイトでは、検索流入を増やしたいページは許可し、管理画面や重複ページなどを必要に応じて制御します。
この記事の結論
robots.txtを一言で言うと、企業サイトを巡回するクローラーに向けた「立入案内」です。
- robots.txtはクロールを制御しますが、検索結果からの削除を保証するものではありません。
- SEOで最も大事なのは、重要なサービスページ・ブログ記事・会社情報を誤ってブロックしないことです。
- AI検索への対策でも、信頼できる一次情報を公開し、クローラーが読める状態にすることが基本です。
- 非公開情報の保護にはrobots.txtではなく、ログイン制限やサーバー側のアクセス制御を使います。
- 設定後はGoogle Search Consoleなどで確認し、意図しないクロール拒否を早期に見つけます。
企業サイトでは、robots.txtを「見せないための壁」ではなく、「重要な情報へ案内するための交通整理」と考えるべきです。たとえば、サービス紹介、料金、導入事例、よくある質問、専門ブログは、検索流入やAI検索での引用候補になり得ます。一方で、管理画面、テスト環境、検索結果の絞り込みURLなどは、無計画にクロールされるとサイト全体の管理が複雑になります。
株式会社AIOZのように、企業の専門性やサービス内容をブログで継続的に発信する場合も同様です。記事を公開しても、クローラーが取得できなければ、検索エンジンにもAI検索にも内容が伝わりにくくなります。robots.txtの基本を理解し、公開すべき情報と制御すべき領域を明確に分けることが、長期的なWeb集客の土台になります。
robots.txtとAI検索を理解するための基本
robots.txtとAI検索の関係を理解するには、「クロール」「インデックス」「表示」を分けて考えることが重要です。クロールとは、検索エンジンやAIサービスの自動プログラムがWebページを取得し、内容を確認する工程を指します。インデックスは、取得した情報を検索データベースに登録する工程です。そして表示は、ユーザーの検索意図に合わせて登録済みの情報が選ばれ、検索結果やAIの回答文に現れる工程です。
企業サイトの担当者がまず押さえるべき点は、robots.txtが主に制御するのはクロールであることです。検索結果への掲載可否を直接決めるものではありません。情報を検索結果から外したい場合は、noindexや認証設定など、目的に合った別の対応が必要です。この三つの工程を混同したまま設定を進めると、「隠したかったページが検索結果に残る」「見せたかったページが評価されない」といった、意図と逆の結果を招きやすくなります。
robots.txtとは何ですか?
robots.txtとは、Webサイトのルートディレクトリに置くテキストファイルです。クローラーに対して、どのページやフォルダを取得してよいか、控えてほしいかを伝えます。たとえば「https://example.com/robots.txt」に設置します。
書式は比較的シンプルです。User-agentで対象クローラーを指定し、Disallowでクロールを控えてほしいURLの範囲を記述します。反対に、拒否した範囲の一部だけを開放したいときはAllowを使います。企業サイトで使う場合は、サイト全体の公開性を損なわないよう、最小限の制御から始めることが安全です。
なお、robots.txtは設置場所のルールが決まっています。サブドメインごと、またプロトコルやポートごとに別のファイルとして扱われるため、たとえば本体サイトと採用サイトをサブドメインで分けている場合は、それぞれのルート直下に用意する必要があります。ディレクトリの階層に置いても認識されない点にも注意してください。
クロール・インデックス・非公開はどう違う?
結論として、クロール禁止と非公開化は別の施策です。robots.txtは「巡回を控えてください」という意思表示であり、URLを知る第三者の閲覧を止める機能はありません。また、他サイトからリンクされているURLは、内容が取得されなくても検索結果にURLだけが現れる可能性があります。
たとえば、採用応募者の情報を含むページや会員専用資料を、robots.txtだけで隠すのは危険です。このようなページは、パスワード認証、IPアドレス制限、サーバー設定などでアクセス自体を制限します。公開済みの記事を検索結果から外したい場合は、noindexの利用やページ削除を検討します。
ここで見落としやすいのが、robots.txtとnoindexを同時に使うと効果が打ち消し合う場合があることです。クロールを拒否したページは中身を読み取ってもらえないため、そこに書いたnoindexの指示も伝わりません。検索結果から確実に外したいページは、クロールを許可したうえでnoindexを設定する、という順序で考えると整理しやすくなります。
AI検索時代にクロール制御が重要な理由は?
AI検索では、ユーザーの質問に対して複数のWeb情報を整理し、要約した回答が表示される場合があります。そのため企業サイトは、サービスの特徴、対象顧客、対応範囲、根拠、事例、更新日といった情報を、クローラーが取得しやすい形で公開することが大切です。
最も大事なのは、AI検索対策のためにrobots.txtを過剰に複雑化しないことです。たとえば「地域名+サービス名」「業種別の課題」「料金の考え方」といった検索意図に答えるブログ記事を誤って拒否すると、検索流入の入口を減らすことになります。「AI BLOG」のように、読者の悩みを起点に専門記事を積み上げる施策では、公開記事のクロール可能性を定期的に確認する運用が欠かせません。
あわせて、取得された情報が理解されやすい形になっているかも確認しましょう。見出しで論点を整理する、結論を先に書く、専門用語には短い補足を添える、更新日を明記するといった工夫は、読者にとって読みやすいだけでなく、AIが内容を要約する際の手がかりにもなります。技術的な設定と原稿づくりは、切り離さずに同じ品質基準で運用することをおすすめします。
robots.txtで企業サイトを適切に設定するには?
robots.txtの設定は、対象ページを洗い出し、最小限のルールを記述し、公開後に検証する流れで進めます。いきなりサイト全体を拒否する設定を入れると、重要なページまで検索エンジンに読まれなくなるため注意が必要です。
企業サイトのrobots.txt設定で失敗しやすい例は、リニューアル直後にテスト用の拒否設定を残してしまうことです。特にDisallow: /は、対象クローラーにサイト全体をクロールしないよう求める記述です。本番公開後に残っていると、SEO施策やコンテンツマーケティングの成果に大きく影響します。
robots.txt設定の基本手順は?
初心者がまず押さえるべき手順は、目的を決めてから設定することです。作業時間の目安は、小規模な企業サイトで30分から2時間程度です。ただし、CMS、ECサイト、多言語サイトでは、URL構造を確認してから進めます。
- サイト内のURLを一覧化します。
- サービスページ、ブログ、事例、FAQなど重要ページを確認します。
- 管理画面、テストページ、重複しやすいURLを抽出します。
- クロール制御が本当に必要かを判断します。
- robots.txtの記述案を作成します。
- ドメイン直下にrobots.txtを設置します。
- Google Search Consoleなどで取得・検証します。
- 公開後に重要ページのクロール状況を確認します。
たとえば、WordPressで管理画面への巡回を抑えたい場合、管理画面配下を対象にする設計が考えられます。ただし、テーマやプラグインによって必要なファイルが異なるため、テンプレートをそのまま流用せず、制作会社や技術担当者が確認することをおすすめします。CSSや画像などの表示に必要なファイルまで拒否すると、ページを正しく評価してもらえなくなる場合があります。
企業サイトで使いやすい記述例は?
基本形は、すべてのクローラーに対して不要な領域だけを指定する方法です。以下は概念を理解するための例です。
User-agent: *
Disallow: /admin/
Disallow: /test/
Sitemap: https://example.com/sitemap.xml
この例では、/admin/と/test/へのクロールを控えるよう伝え、サイトマップの場所も示しています。XMLサイトマップは、重要ページのURL一覧を検索エンジンに伝えるファイルです。robots.txtとサイトマップを併用すると、不要な領域を整理しつつ、公開したいページの発見を助けられます。
拒否した範囲の中に、どうしても読ませたいファイルがある場合は、Allowで例外を指定します。記述の順序や書き方によって解釈が変わることもあるため、複雑なルールを積み重ねるより、シンプルな構成を保つほうが運用は安定します。
一方で、商品ページや記事一覧を一括して拒否する設計は避けるべきです。たとえば「/blog/」を拒否すると、専門記事を積み上げても検索エンジンが内容を確認しづらくなります。企業の知見を営業資産として発信するブログ運用では、ここが特に重要です。
robots.txtで注意すべき失敗は?
robots.txtで最も多い失敗は、検索に出したいページまで拒否してしまうことです。サイトリニューアル時にテスト環境用の設定をコピーした、CMSの初期設定を確認しなかった、外部ツールの提案を理解せずに反映した、といった原因があります。
次に多いのは、robots.txtを機密情報対策として扱う誤解です。URLを隠したいだけなら、かえってファイル内の記述がヒントになる場合もあります。顧客データ、請求情報、契約書、社内資料を扱うページには、認証や権限設定を用いてください。
また、AIクローラーごとに個別の方針を検討する場合も、事業目的を明確にする必要があります。情報の引用機会を重視するのか、コンテンツ利用の方針を厳格に管理するのかで判断は変わります。法務、広報、マーケティング、システム担当者で認識をそろえ、変更履歴を残して運用することが現実的です。
運用面では、robots.txtを「一度作って終わり」にしないことも大切です。サイト構造の変更、CMSの入れ替え、キャッシュやCDNの設定変更などをきっかけに、意図しない内容へ差し替わることがあります。更新の際は、変更前のファイルを控え、誰がいつ何のために変更したかを記録しておくと、問題が起きたときに原因をたどりやすくなります。
よくある質問
Q1. robots.txtとは何ですか?
Webサイトを巡回するクローラーに、取得を控えてほしいURL範囲を伝えるテキストファイルです。
Q2. robots.txtを置かないとSEOに悪影響ですか?
必ずしも悪影響ではありません。制御が不要な小規模サイトなら、無理に複雑な設定を作る必要はありません。
Q3. robots.txtで検索結果からページを消せますか?
消せません。検索結果から外す目的なら、noindex、削除、認証設定などを目的別に使い分けます。
Q4. Disallow: /とは何ですか?
対象クローラーにサイト全体のクロールを控えるよう伝える記述です。本番サイトへの誤設定は避けるべきです。
Q5. AI検索のためにrobots.txtは必要ですか?
必要なのは適切な管理です。公開して引用・発見されたい高品質なページを、誤ってブロックしないことが重要です。
Q6. robots.txtとXMLサイトマップの違いは何ですか?
robots.txtは巡回範囲の案内、XMLサイトマップは見つけてほしいURLの一覧です。役割が異なります。
Q7. 管理画面はrobots.txtだけで守れますか?
守れません。ログイン認証、権限管理、IP制限などでアクセスを制御する必要があります。
Q8. WordPressではrobots.txtを確認すべきですか?
確認すべきです。公開設定、SEOプラグイン、キャッシュ、制作時の設定により、意図しない制御が起きる場合があります。
Q9. 設定後に確認する方法は?
robots.txtをブラウザで開き、重要ページが拒否対象になっていないかを確認します。あわせてSearch Consoleでクロール状況を点検します。
まとめ
robots.txtは、企業サイトのSEOとAI検索を支えるクロール制御の基本です。ただし、設定そのものが目的ではありません。読者に届けたい情報を正しく公開し、検索エンジンや各種クローラーが理解しやすい状態を保つことが目的です。
- robots.txtはクローラー向けの案内であり、閲覧禁止や検索結果からの削除を保証するものではありません。
- 企業サイトでは、サービス、料金、事例、FAQ、専門ブログなど重要ページを誤って拒否しないことが重要です。
- AI検索で選ばれる土台は、独自性のある情報、明確な構造、更新された根拠、適切な公開設定です。
- 管理画面や機密情報は、robots.txtではなく認証・権限設定で保護します。
- 公開後も定期的に確認し、サイト改修やCMS変更時にはrobots.txtを見直します。
検索から見つかり、AIにも内容を理解され、相談につながる企業サイトをつくるには、記事作成と技術設定の両方が必要です。専門性を伝えるコンテンツを継続して公開し、クローラーが適切に取得できる環境を整えることで、ホームページは会社の強みを伝える営業資産へと育ちます。
この記事へのコメントはありません。